Windows Server wird in Unternehmensinfrastrukturen zur Benutzerverwaltung sowie zum Betrieb von Anwendungen, Dateidiensten, Datenbanken und virtuellen Maschinen eingesetzt. Die Stabilität dieser Systeme ist entscheidend für die Arbeit der Mitarbeiter und die Verfügbarkeit geschäftskritischer Prozesse. Doch selbst ein korrekt konfigurierter Server kann durch Ressourcenengpässe, Softwarefehler oder Hardwaredefekte beeinträchtigt werden.
Durch das Monitoring von Windows Server lassen sich potenzielle Probleme erkennen, bevor schwerwiegende Störungen auftreten. Dafür musst du nicht nur die Auslastung von Prozessor und Arbeitsspeicher, sondern auch den Zustand der Datenträger, des Netzwerks, der Systemdienste und der Ereignisprotokolle überwachen.
Wie effektiv das Monitoring funktioniert, hängt von der richtigen Auswahl der Kennzahlen, Tools und Schwellenwerte ab. Moderne IT Infrastructure Management Solutions können dir dabei helfen, diese Aufgaben zentral zu organisieren und die Überwachung mehrerer Systeme zu vereinfachen. Zu viele Benachrichtigungen führen zu einer Informationsflut, während eine unzureichende Überwachung dazu führen kann, dass kritische Vorfälle unbemerkt bleiben. Im Folgenden betrachten wir die wichtigsten Metriken, geeignete Monitoring-Tools für Windows Server und die Einrichtung eines zuverlässigen Benachrichtigungssystems.
Welche Windows Server-Kennzahlen solltest du überwachen?
Das Monitoring muss die jeweilige Serverrolle und die Art der Arbeitslast berücksichtigen. Ein Domänencontroller, ein Dateiserver, ein SQL Server und ein Hyper-V-Host haben unterschiedliche Leistungsanforderungen. Deshalb sind einheitliche Schwellenwerte nicht für alle Systeme geeignet.
Dennoch gibt es einige grundlegende Kategorien von Kennzahlen, die du auf nahezu jedem Windows Server überwachen solltest.
Prozessorauslastung (CPU)
Eine hohe CPU-Auslastung ist nicht zwangsläufig ein Problem. Kurzzeitige Lastspitzen können bei Backups, Updates oder rechenintensiven Aufgaben auftreten. Kritisch wird es, wenn die Auslastung über längere Zeit hoch bleibt und gleichzeitig die Anwendungsleistung nachlässt.
Für die Analyse verwendest du folgende Leistungsindikatoren im Performance Monitor:
- \Processor(_Total)\% Processor Time – gesamte Prozessorauslastung.
- \System\Processor Queue Length – Anzahl der Threads, die auf Prozessorzeit warten.
- \Process(*)\% Processor Time – CPU-Auslastung einzelner Prozesse.
Als ersten Richtwert kannst du eine Warnung bei einer CPU-Auslastung von über 85 % über einen Zeitraum von 10 bis 15 Minuten einrichten. Der endgültige Schwellenwert sollte jedoch anhand des normalen Lastprofils des jeweiligen Servers festgelegt werden.
Arbeitsspeicher (RAM)
Ein Mangel an verfügbarem Arbeitsspeicher kann zu einer intensiven Nutzung der Auslagerungsdatei und einer Verlangsamung von Anwendungen führen. Eine hohe RAM-Auslastung allein ist jedoch kein Anzeichen für eine Störung, da Windows freien Arbeitsspeicher aktiv für Caching nutzt.
Besonders hilfreich sind folgende Kennzahlen:
- \Memory\Available MBytes – verfügbarer physischer Arbeitsspeicher.
- \Memory\Pages/sec – Häufigkeit von Vorgängen im Zusammenhang mit dem Zugriff auf Speicherseiten.
- \Memory\Committed Bytes – Umfang des zugesicherten virtuellen Speichers.
Deine Benachrichtigungen sollten nicht ausschließlich auf dem prozentualen RAM-Verbrauch basieren. Sinnvoller ist es, einen dauerhaft sinkenden verfügbaren Arbeitsspeicher in Verbindung mit zunehmender Auslagerungsaktivität zu überwachen.
Datenträger und Speichersysteme
Probleme mit Datenträgern führen häufig zu Leistungseinbußen bei Anwendungen, Datenbanken und Dateidiensten. Dein Monitoring sollte den verfügbaren Speicherplatz, die Latenz von Ein- und Ausgabeoperationen sowie den Zustand der Laufwerke berücksichtigen.
Wichtige Kennzahlen sind:
- \LogicalDisk(*)\% Free Space – Anteil des freien Speicherplatzes.
- \LogicalDisk(*)\Free Megabytes – verfügbarer Speicherplatz in Megabyte.
- \PhysicalDisk(*)\Avg. Disk sec/Read – durchschnittliche Leselatenz.
- \PhysicalDisk(*)\Avg. Disk sec/Write – durchschnittliche Schreiblatenz.
Für Systempartitionen kannst du zunächst eine Warnung einrichten, wenn weniger als 15–20 % des Speicherplatzes frei sind. Bei großen Volumes ist ein prozentualer Schwellenwert jedoch nicht immer aussagekräftig. Hier sind der absolute freie Speicherplatz und die Geschwindigkeit, mit der er abnimmt, wichtiger.
Latenzwerte musst du unter Berücksichtigung des Speichermediums, der Storage-Architektur und der Anforderungen der Anwendungen interpretieren.
Netzwerk und Verfügbarkeit von Diensten
Ein Server kann weiterhin laufen, für Benutzer aber aufgrund von Netzwerkproblemen, DNS-Fehlern oder ausgefallenen Diensten nicht erreichbar sein.
Für deine Diagnose sind folgende Kennzahlen hilfreich:
- \Network Interface(*)\Bytes Total/sec – Umfang des Netzwerkverkehrs.
- \Network Interface(*)\Output Queue Length – Warteschlange ausgehender Pakete.
- \TCPv4\Connections Established – Anzahl bestehender TCP-Verbindungen.
Zusätzlich solltest du die Erreichbarkeit der benötigten TCP-Ports und die Verfügbarkeit der Anwendungsdienste überprüfen. Eine erfolgreiche Antwort auf eine ICMP-Anfrage garantiert beispielsweise nicht, dass IIS, SQL Server oder ein Remotezugriffsdienst ordnungsgemäß funktionieren.
Überwachung von Systemdiensten und Ereignisprotokollen
Neben der Hardwareleistung musst du auch den Status der Windows-Dienste überwachen. Wenn ein Dienst unerwartet beendet wird, kann dies den Betrieb von Anwendungen beeinträchtigen, selbst wenn CPU-, RAM- und Datenträgerkennzahlen unauffällig sind.
Besondere Aufmerksamkeit verdienen Active Directory Domain Services, DNS Server, DHCP Server, Windows Update, IIS und weitere Komponenten, abhängig von der jeweiligen Serverrolle.
Zur Fehleranalyse dient das Windows Event Log. Besonders wichtig sind die Protokolle System, Application und Security. Darin werden Systemfehler, Anwendungsabstürze, Authentifizierungsereignisse und sicherheitsrelevante Änderungen erfasst.
Allerdings ist es nicht sinnvoll, für jedes Ereignis mit dem Schweregrad Warning oder Error eine Benachrichtigung zu versenden. Viele Einträge erfordern kein sofortiges Eingreifen. Besser ist eine gezielte Filterung nach Ereignisquellen, Ereignis-IDs und der Häufigkeit bestimmter Fehler.
Bei Domänencontrollern sind zusätzlich der Zustand der Active-Directory-Replikation, die DNS-Verfügbarkeit und Authentifizierungsfehler wichtig. Bei Hyper-V solltest du den Zustand der virtuellen Maschinen, die Ressourcenauslastung des Hosts und die Verfügbarkeit der Speichersysteme überwachen.
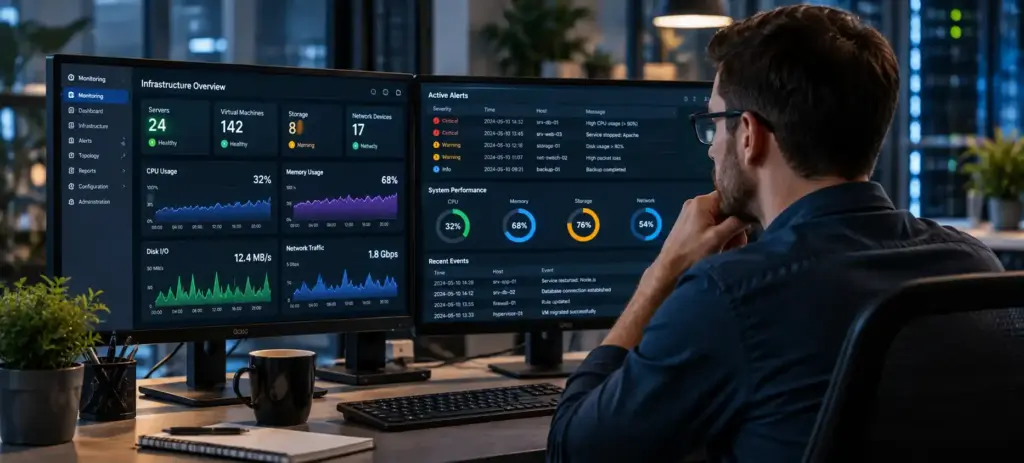
Tools für das Windows Server Monitoring
Für das Monitoring kannst du integrierte Windows-Werkzeuge oder spezialisierte Plattformen einsetzen. Die Wahl hängt von der Anzahl der Server, der Komplexität der Infrastruktur und den Anforderungen an die zentrale Verwaltung ab.
Integrierte Windows-Tools
Performance Monitor (PerfMon) ermöglicht dir die Überwachung von Leistungsindikatoren, die Analyse der Systemleistung und die Erfassung historischer Daten. Das Tool eignet sich für die Diagnose einzelner Server und die Untersuchung von Leistungsproblemen.
Event Viewer (Ereignisanzeige) dient zur Anzeige und Filterung von Windows-Ereignisprotokollen. Damit kannst du Dienstfehler, Hardwareprobleme und sicherheitsrelevante Ereignisse identifizieren.
Windows Admin Center bietet dir eine webbasierte Oberfläche für die Serveradministration, die Anzeige wichtiger Kennzahlen und die Durchführung diagnostischer Aufgaben.
Diese Werkzeuge sind für lokale Analysen hilfreich. Bei der Betreuung von mehreren Dutzend Servern ist ein zentrales Monitoring-System jedoch in der Regel praktischer.
Spezialisierte Monitoring-Plattformen
PRTG Network Monitor unterstützt die Überwachung von Windows-Systemen über WMI, SNMP und weitere Mechanismen. Die Plattform bietet vorkonfigurierte Sensoren, die Visualisierung von Kennzahlen und flexible Benachrichtigungseinstellungen.
Zabbix ist eine Open-Source-Monitoring-Lösung. Mit dem Zabbix Agent kannst du Kennzahlen von Windows Server erfassen sowie Dienste, Ereignisprotokolle und die Anwendungsleistung überwachen.
Checkmk bietet eine automatische Erkennung von Diensten, Infrastruktur-Monitoring und eine zentrale Verwaltung von Alarmierungen. Die Lösung eignet sich für mittlere und große Serverumgebungen.
Microsoft System Center Operations Manager (SCOM) ist auf die zentrale Überwachung von Microsoft-Unternehmensinfrastrukturen ausgerichtet. Die Plattform unterstützt spezialisierte Management Packs für Windows Server und verschiedene Serveranwendungen.
Bei der Auswahl eines Tools solltest du nicht nur die Lizenzkosten, sondern auch den Implementierungsaufwand, die Wartungsanforderungen sowie die Integrations- und Skalierungsmöglichkeiten berücksichtigen.
So richtest du Benachrichtigungen richtig ein
Die wichtigste Aufgabe deines Alarmierungssystems besteht darin, dich rechtzeitig über Probleme zu informieren, die ein Eingreifen erfordern. Wenn dein Monitoring täglich Hunderte unwichtiger Meldungen versendet, können kritische Ereignisse übersehen werden.
Einteilung nach Kritikalität
Eine Unterteilung in drei Benachrichtigungsstufen ist sinnvoll:
- Information – informative Ereignisse, die kein sofortiges Eingreifen erfordern.
- Warning – Abweichungen, die bei anhaltender Entwicklung zu Problemen führen können.
- Critical – Störungen, die sich unmittelbar auf die Verfügbarkeit oder Funktionsfähigkeit von Systemen auswirken.
Beispielsweise kannst du bei einem Rückgang des freien Speicherplatzes auf 20 % eine Warnung und bei 5 % eine kritische Meldung auslösen lassen. Diese Werte musst du jedoch an die Größe des Datenträgers und die Geschwindigkeit der Speicherbelegung anpassen.
Verwendung von Zeitintervallen
Nicht jede kurzzeitige Überschreitung eines Schwellenwerts sollte einen Alarm auslösen. Für die CPU kannst du beispielsweise folgende Bedingung definieren: eine Auslastung von über 85 % für mindestens zehn Minuten.
Auch bei der Netzwerküberwachung solltest du kurzfristige Paketverluste und vorübergehende Verzögerungen berücksichtigen.
Zeitintervalle helfen dir, Fehlalarme zu reduzieren, ohne die Erkennung anhaltender Probleme zu beeinträchtigen.
Ereigniskorrelation
Ein einzelner technischer Fehler kann Dutzende zusammenhängender Benachrichtigungen auslösen. Beispielsweise führt der Ausfall eines Netzwerk-Switches dazu, dass mehrere Server und Anwendungen nicht mehr erreichbar sind.
Dein Monitoring-System sollte nach Möglichkeit die eigentliche Ursache identifizieren und voneinander abhängige Ereignisse zusammenfassen. Dadurch sinkt die Anzahl der Meldungen und die Fehlerdiagnose wird beschleunigt.
Benachrichtigungskanäle und Eskalation
Unkritische Ereignisse kannst du per E-Mail versenden oder im Monitoring-Dashboard anzeigen lassen. Bei schwerwiegenden Vorfällen sind zusätzliche Kanäle sinnvoll, beispielsweise Messenger, SMS oder eine Integration in das Service-Desk-System.
Wichtig ist, dass du im Voraus festlegst, wer zu welchen Zeiten Benachrichtigungen erhält und was geschieht, wenn der zuständige Spezialist auf einen kritischen Alarm nicht reagiert.
Praktische Checkliste für die Einrichtung des Windows Server Monitorings
Bevor du ein Monitoring-System in Betrieb nimmst, solltest du folgende Punkte überprüfen:
- Inventarisierung. Eine vollständige Liste der Server, ihrer Rollen, Anwendungen und geschäftskritischen Dienste wurde erstellt.
- Grundlegende Kennzahlen. Die Erfassung von CPU-, RAM-, Datenträger- und Netzwerkkennzahlen ist eingerichtet.
- Systemdienste. Der Status aller für den Anwendungsbetrieb erforderlichen Dienste wird überwacht.
- Ereignisprotokolle. Eine Filterung relevanter Fehler im Windows Event Log ist konfiguriert.
- Anwendungsmonitoring. Die Verfügbarkeit von IIS, SQL Server, Active Directory und weiteren eingesetzten Diensten wird überprüft.
- Historische Daten. Messwerte werden gespeichert, um Trends zu analysieren und Ressourcen zu planen.
- Schwellenwerte. Warn- und kritische Schwellenwerte sind entsprechend der normalen Systemauslastung definiert.
- Benachrichtigungen. Zuständige Spezialisten, Kommunikationskanäle und Eskalationsverfahren sind festgelegt.
- Funktionstests. Die Alarmierung wurde anhand sicher simulierter Ausfallszenarien getestet.
- Regelmäßige Überprüfung. Schwellenwerte und Regeln werden bei Änderungen der Arbeitslast oder Infrastrukturkonfiguration angepasst.
Nach der Ersteinrichtung empfiehlt es sich, über mehrere Wochen statistische Daten zu sammeln. So kannst du typische Lastwerte ermitteln und überflüssige Benachrichtigungen vermeiden.